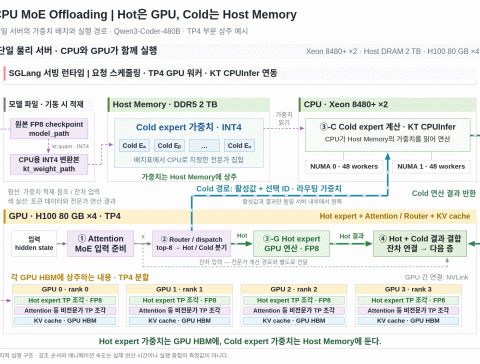
LLM INFERENCE · CPU–GPU HYBRID CPU MoE Offloading:GPU 메모리의 한계를 넘으면 무엇이 달라질까 Hot expert는 GPU에, Cold expert는 Host Memory에: 실행 구조와 기본 성능, 최적화의 출발점 그림 움직임 멈춤 큰
글쓰기, 여행, 프로그래밍, 리뷰
LLM INFERENCE · CPU–GPU HYBRID CPU MoE Offloading:GPU 메모리의 한계를 넘으면 무엇이 달라질까 Hot expert는 GPU에, Cold expert는 Host Memory에: 실행 구조와 기본 성능, 최적화의 출발점 그림 움직임 멈춤 큰
칩이 아니라 ‘공장’을 판다 — NVIDIA가 AI 팩토리 전체를 하나의 청사진으로 묶었다. · NVIDIA DSX 종합 분석 전력이 병목인 시대, 경쟁의 단위는 FLOPS가 아니라 ‘메가와트당 토큰’이다. NVIDIA DSX는 단일 칩·서버

Classical IDC에서 AIDC로 — 16-Layer 패러다임 전환 Uptime을 임대하던 부동산이 → tokens/watt를 생산하는 공장이 되었다 Classical IDC와 AIDC는 같은 단어 두 개로 묶이지만, 전력·냉각·네트워크·운영 KPI가 사실상 다른 운영 체계다 —

AI 개발에 대규모 GPU는 필수적인 요소로 간주된다. 한국 정부는 2025년 초 부족한 GPU를 공공 인프라 형태로 제공할 계획을 발표하였다. 이 시리즈의 핵심 주제이기도 하다. 그런데 국내외적으로 다양한 설계를 기반으로 다양한

GPU에 대해서 자세히 알아 보기 위해서는 AI 발전의 역사를 살펴 보아야 한다. 특히 2번째 AI 겨울을 끝내고 지금의 AI 기술의 확산에 큰 기둥 중 하나이기 때문이다. 그래서 이번 포스팅에서는 1950년대

이번 포스팅에서는 GPU가 어떻게 AI 시대의 핵심이 되었는지를 알아보겠다. 우선 GPU의 탄생 배경에 대해서 이야기를 좀 하려고 한다. GPU라는 기술은 결국 연산을 수행하는 장치이고, 그 연산 능력은 반도체 기술의 진보에

이번 포스팅에서는 GTC 2025 키노트 발표 내용 중 Hopper의 성능 향상을 설명하는 그래프를 해석해 보자. 젠슨 황이 발표 중에 “우리는 수학적인 표현을 대중적인 스피치에서 전달하는 몇 안 되는 회사다”라고 말하기도