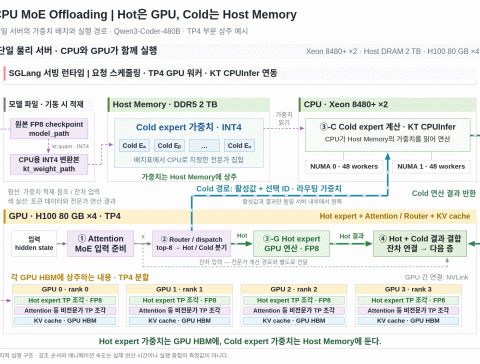
LLM INFERENCE · CPU–GPU HYBRID CPU MoE Offloading:GPU 메모리의 한계를 넘으면 무엇이 달라질까 Hot expert는 GPU에, Cold expert는 Host Memory에: 실행 구조와 기본 성능, 최적화의 출발점 그림 움직임 멈춤 큰
글쓰기, 여행, 프로그래밍, 리뷰
LLM INFERENCE · CPU–GPU HYBRID CPU MoE Offloading:GPU 메모리의 한계를 넘으면 무엇이 달라질까 Hot expert는 GPU에, Cold expert는 Host Memory에: 실행 구조와 기본 성능, 최적화의 출발점 그림 움직임 멈춤 큰

vLLM Performance · Engineering Notes 코드 한 줄 고치지 않고, vLLM에 이미 들어 있는 내장 설정만으로 Llama-3.3-70B 추론을 6개 워크로드 전부 가속한 156셀 측정 리포트. ────────────────────────────────────── vLLM 소스에는 손대지 않았다.