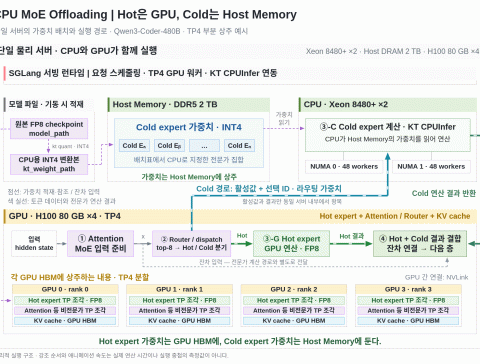
LLM INFERENCE · CPU–GPU HYBRID CPU MoE Offloading:GPU 메모리의 한계를 넘으면 무엇이 달라질까 Hot expert는 GPU에, Cold expert는 Host Memory에: 실행 구조와 기본 성능, 최적화의 출발점 그림 움직임 멈춤 큰
글쓰기, 여행, 프로그래밍, 리뷰
LLM INFERENCE · CPU–GPU HYBRID CPU MoE Offloading:GPU 메모리의 한계를 넘으면 무엇이 달라질까 Hot expert는 GPU에, Cold expert는 Host Memory에: 실행 구조와 기본 성능, 최적화의 출발점 그림 움직임 멈춤 큰