칩렛(Chiplet) 구조란 무엇인가? AMD, Azure, 리벨리온으로 살펴보는 칩렛의 의미
대표 이미지: Chiplet 패키지의 Exploded View 일러스트(Higgsfield gpt_image_2_5 생성). 아래부터 Package Substrate, Silicon Interposer, 그 위에 Compute Chiplet 4개, I/O Die 2개, HBM Stack 8개가 분리되어 배치됨. 특정 제품의 Floorplan과 무관함
Microsoft는 2026년 10월 12일 OCP Global Summit에서 3세대 자체 Inference 가속기 Maia 300을 공개하였다. 2027년부터 Azure에 배치될 이 제품은 Microsoft가 처음으로 Multi-Chiplet 구조를 채택한 가속기이다. AMD가 MI300X 이래 MI455X에 이르기까지 Compute를 8개 Die로 분할해 온 것과 달리 Microsoft는 Compute Die를 단일로 유지하고 I/O와 Memory Controller만을 별도 Die로 분리하였다. 동일한 Chiplet이라는 명칭 아래 분할의 축이 Compute에서 Memory·I/O로 이동한 것이다. 국내에서는 Rebellions가 2025년 Hot Chips에서 Compute Chiplet 4개를 UCIe로 연결한 REBEL-Quad를 공개하였으며, 이 제품은 AMD, Microsoft와 구분되는 제3의 분할 방식에 해당한다.
1. 세 가속기의 Die 분할 방식
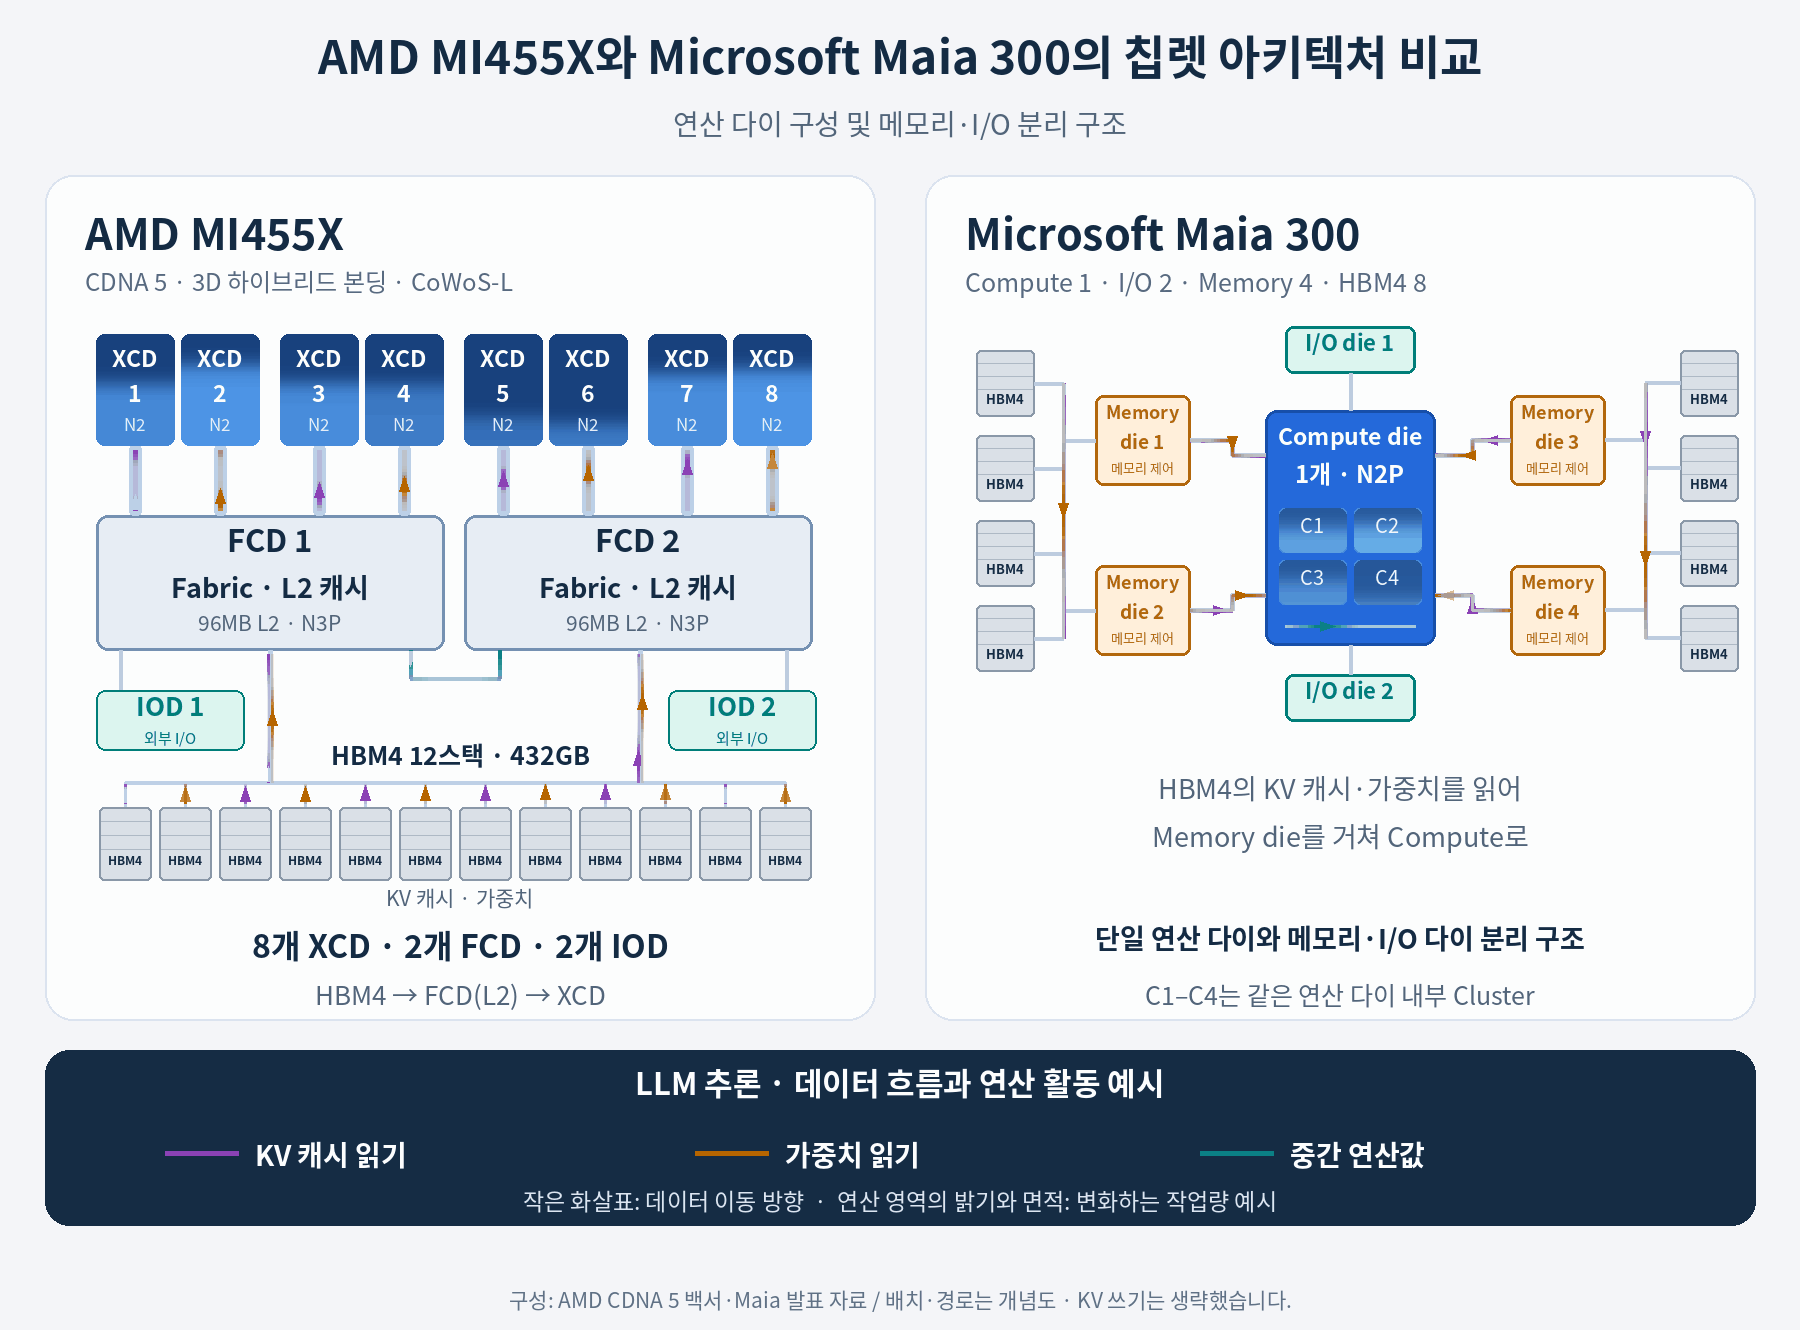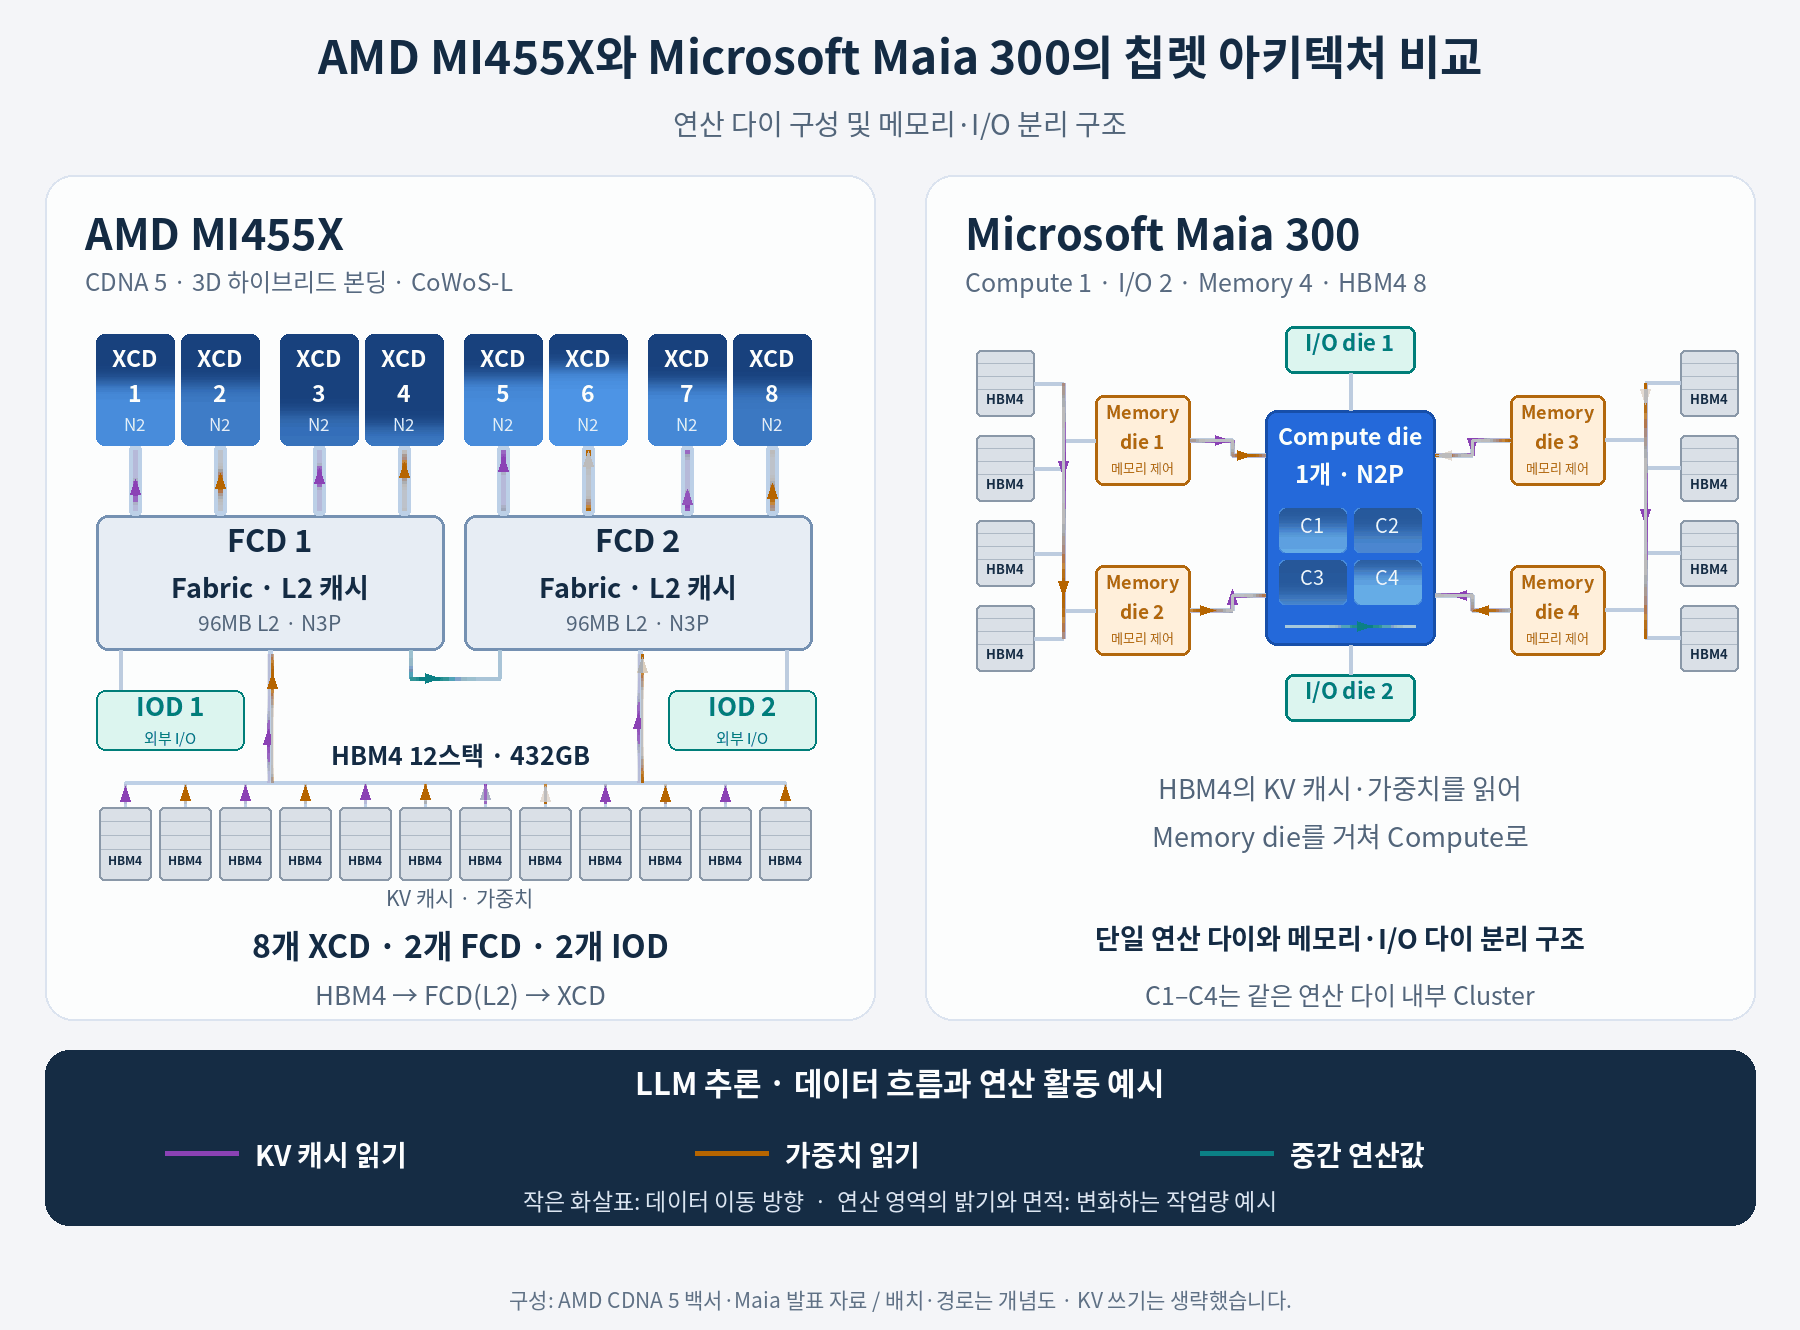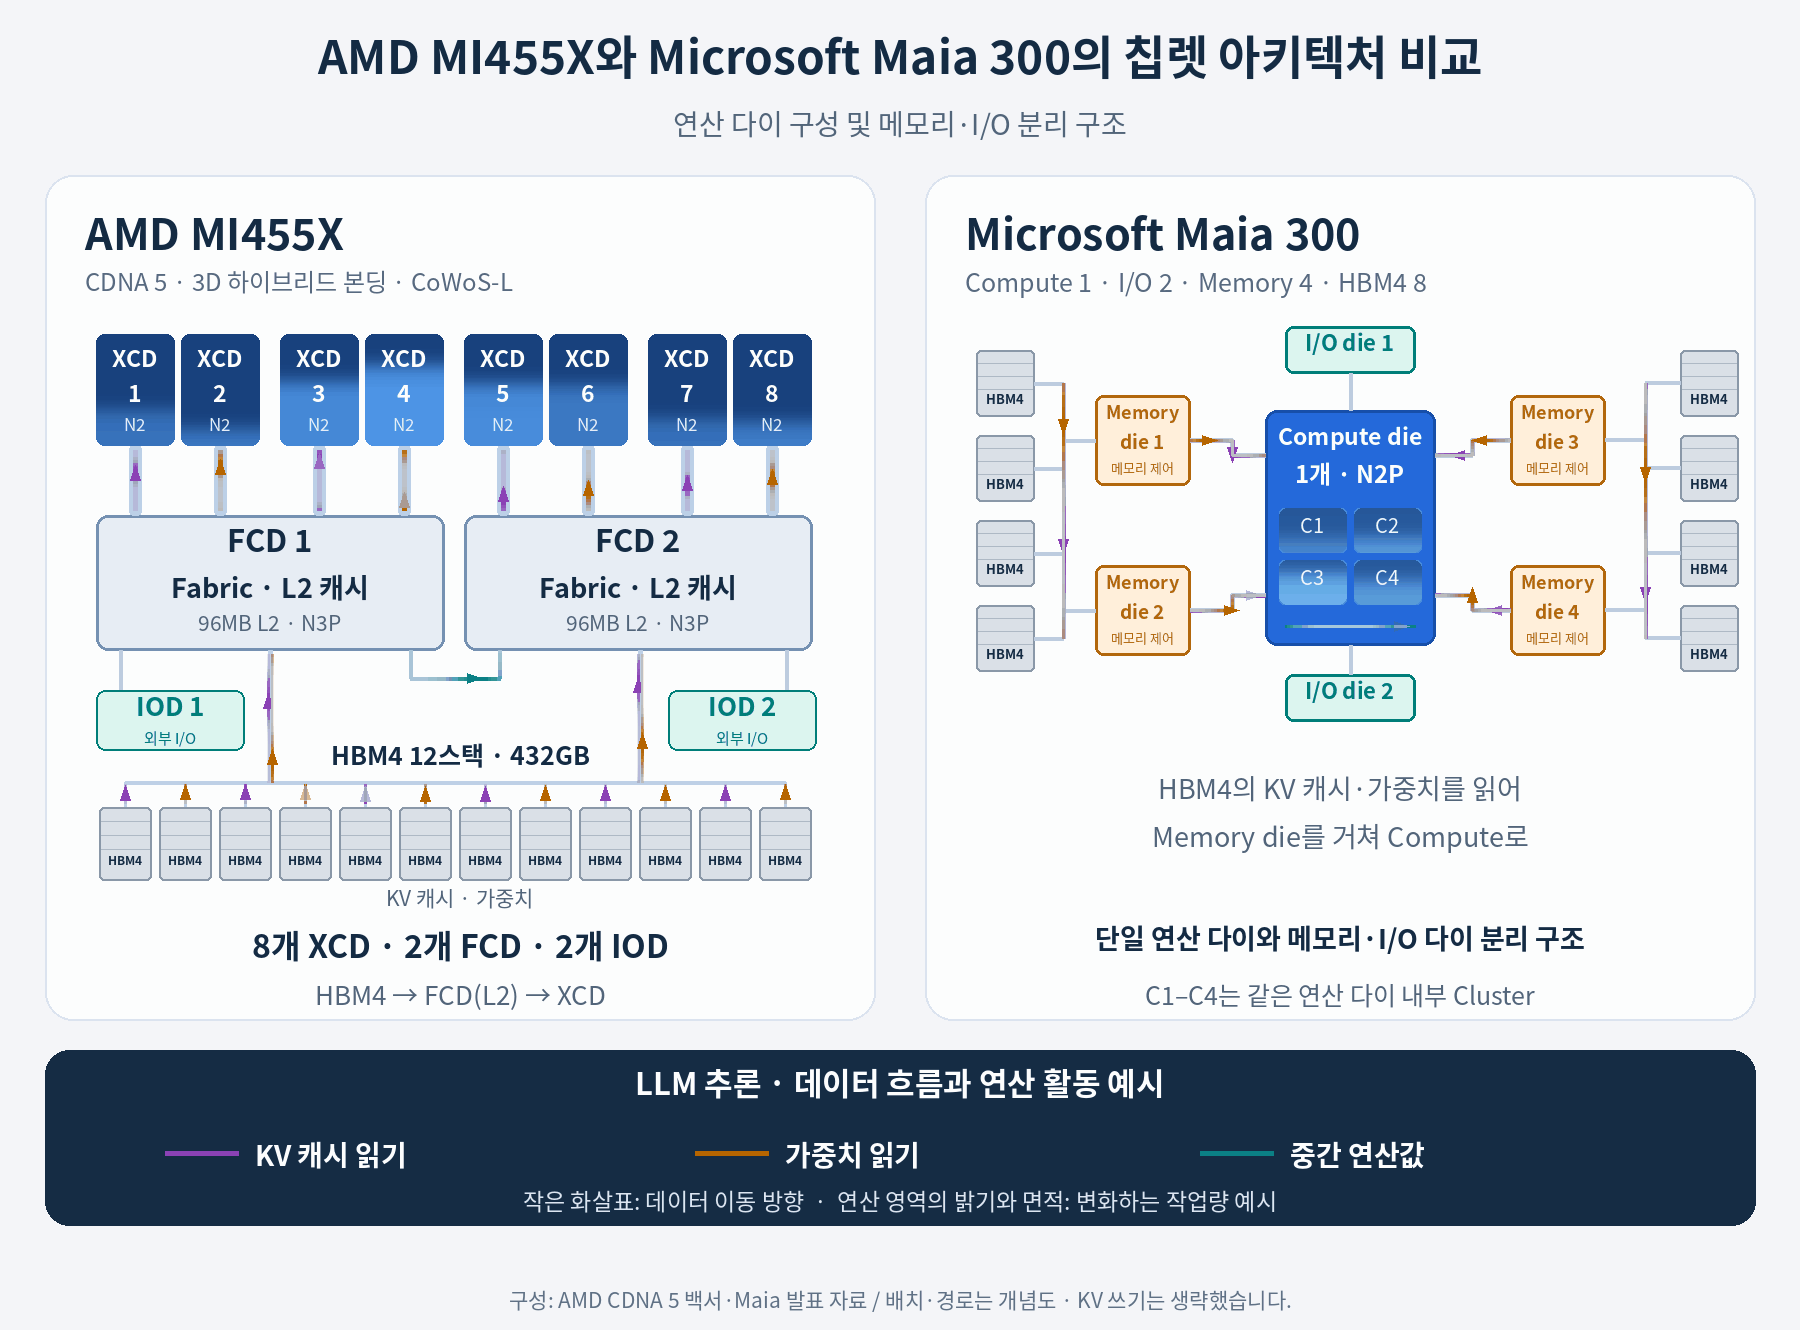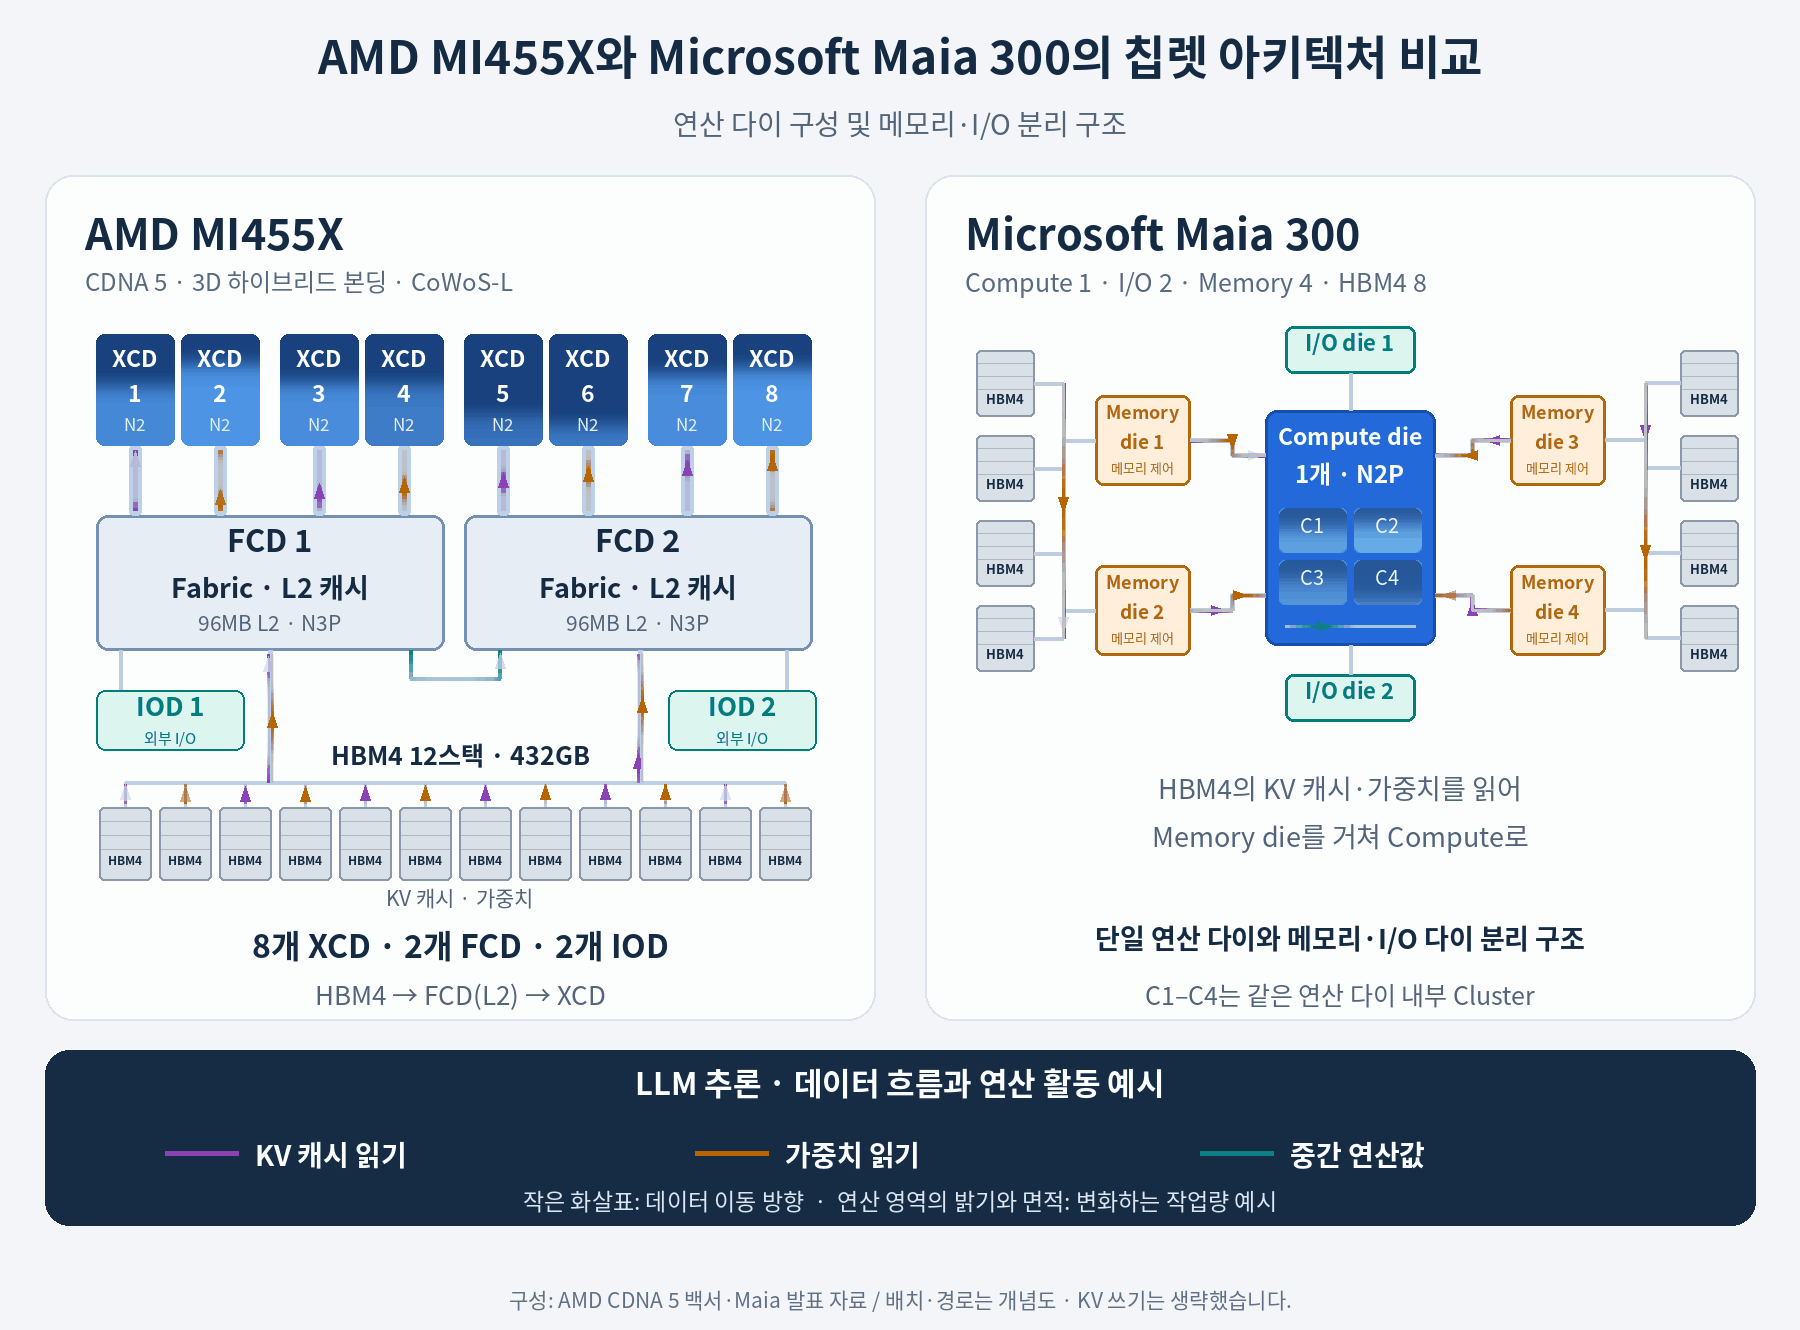
AMD Instinct MI455X(CDNA 5, 2026년 발표)는 TSMC N2 공정의 XCD(Accelerator Complex Die) 8개를 N3 공정의 FCD(Fabric and Cache Die) 2개 위에 Hybrid Bonding으로 수직 적층하고, 여기에 N3 공정의 I/O Die 2개와 HBM4 12 Stack(432GB, 23.3TB/s)을 TSMC CoWoS-L로 결합한 구조이다. XCD 하나는 32개 WGP(Workgroup Processor)를 포함하며, FCD 하나는 96MB L2와 HBM PHY, Infinity Fabric을 수용하여 XCD 4개를 담당한다. I/O Die는 호스트 연결, Scale-up, Scale-out NIC를 맡는다. 전체 Transistor 수는 3,200억 개이고, Peak 연산은 MXFP4 40.3 PFLOPS, MXFP8 20.1 PFLOPS이다. 전 세대 MI355X(2025)가 XCD 8개를 IOD 2개 위에 적층하고 Memory-side Infinity Cache 256MB를 두었던 것과 비교하면, MI455X는 Infinity Cache를 제거하고 FCD의 L2 192MB(96MB × 2)로 대체하였으며 I/O 기능을 별도 Die로 분리하였다. 즉 AMD는 XCD 8개 구조를 세 세대에 걸쳐 유지하면서 하부 Die의 역할을 Cache 중심으로 재편하였다.
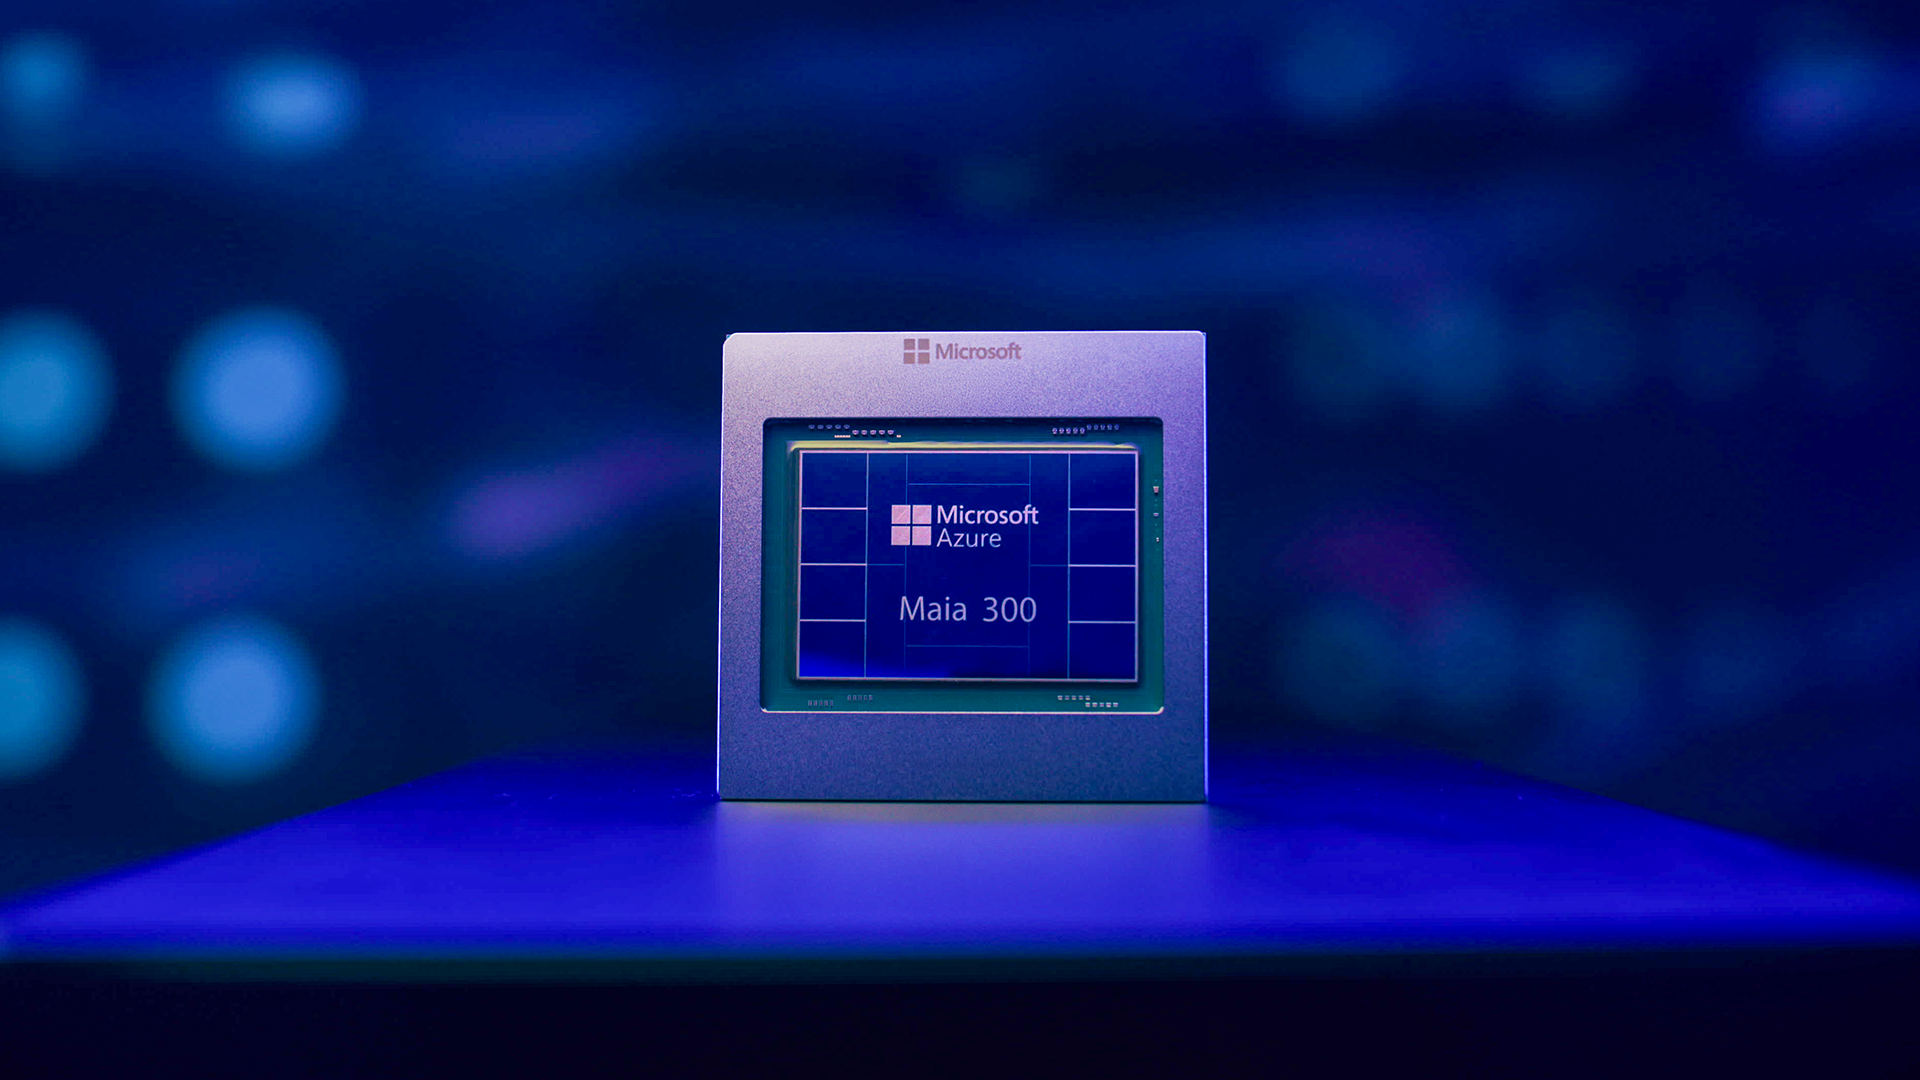
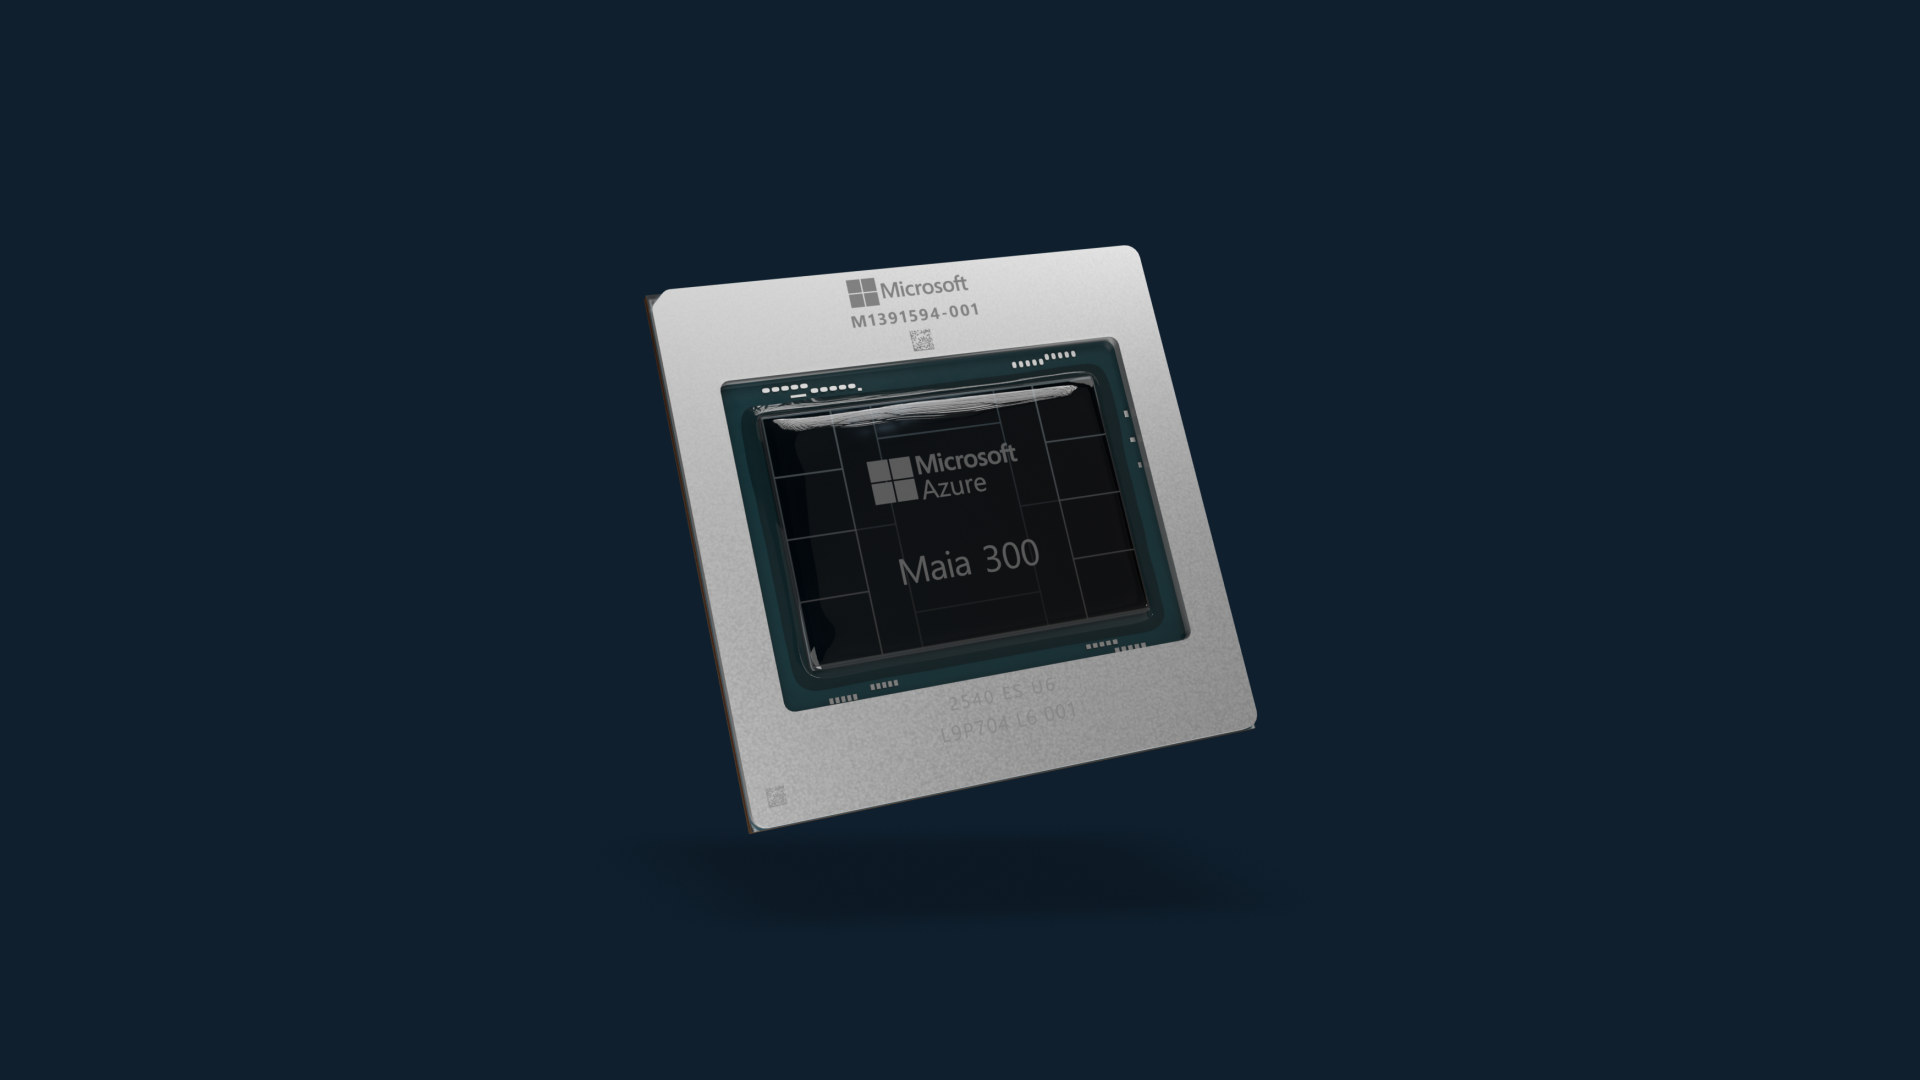
Maia 300은 TSMC N2P Compute Die 1개, I/O Die 2개, Memory Die 4개로 구성되며 HBM4 8 Stack(288GB, 18TB/s)을 탑재한다. Compute Die 내부는 12개 Tile로 구성된 Cluster 4개와 상위 Network-on-Chip으로 이루어지며, 각 Tile은 Tensor Unit, Vector Processor, DMA Engine, Local SRAM을 포함한다. 전 세대 Maia 200(2026년 1월 발표)은 N3P Monolithic Die에 HBM3E 6 Stack(216GB, 7.1TB/s)을 결합한 구조였으므로, Microsoft는 한 세대 만에 Monolithic에서 Chiplet으로 이행한 셈이다.
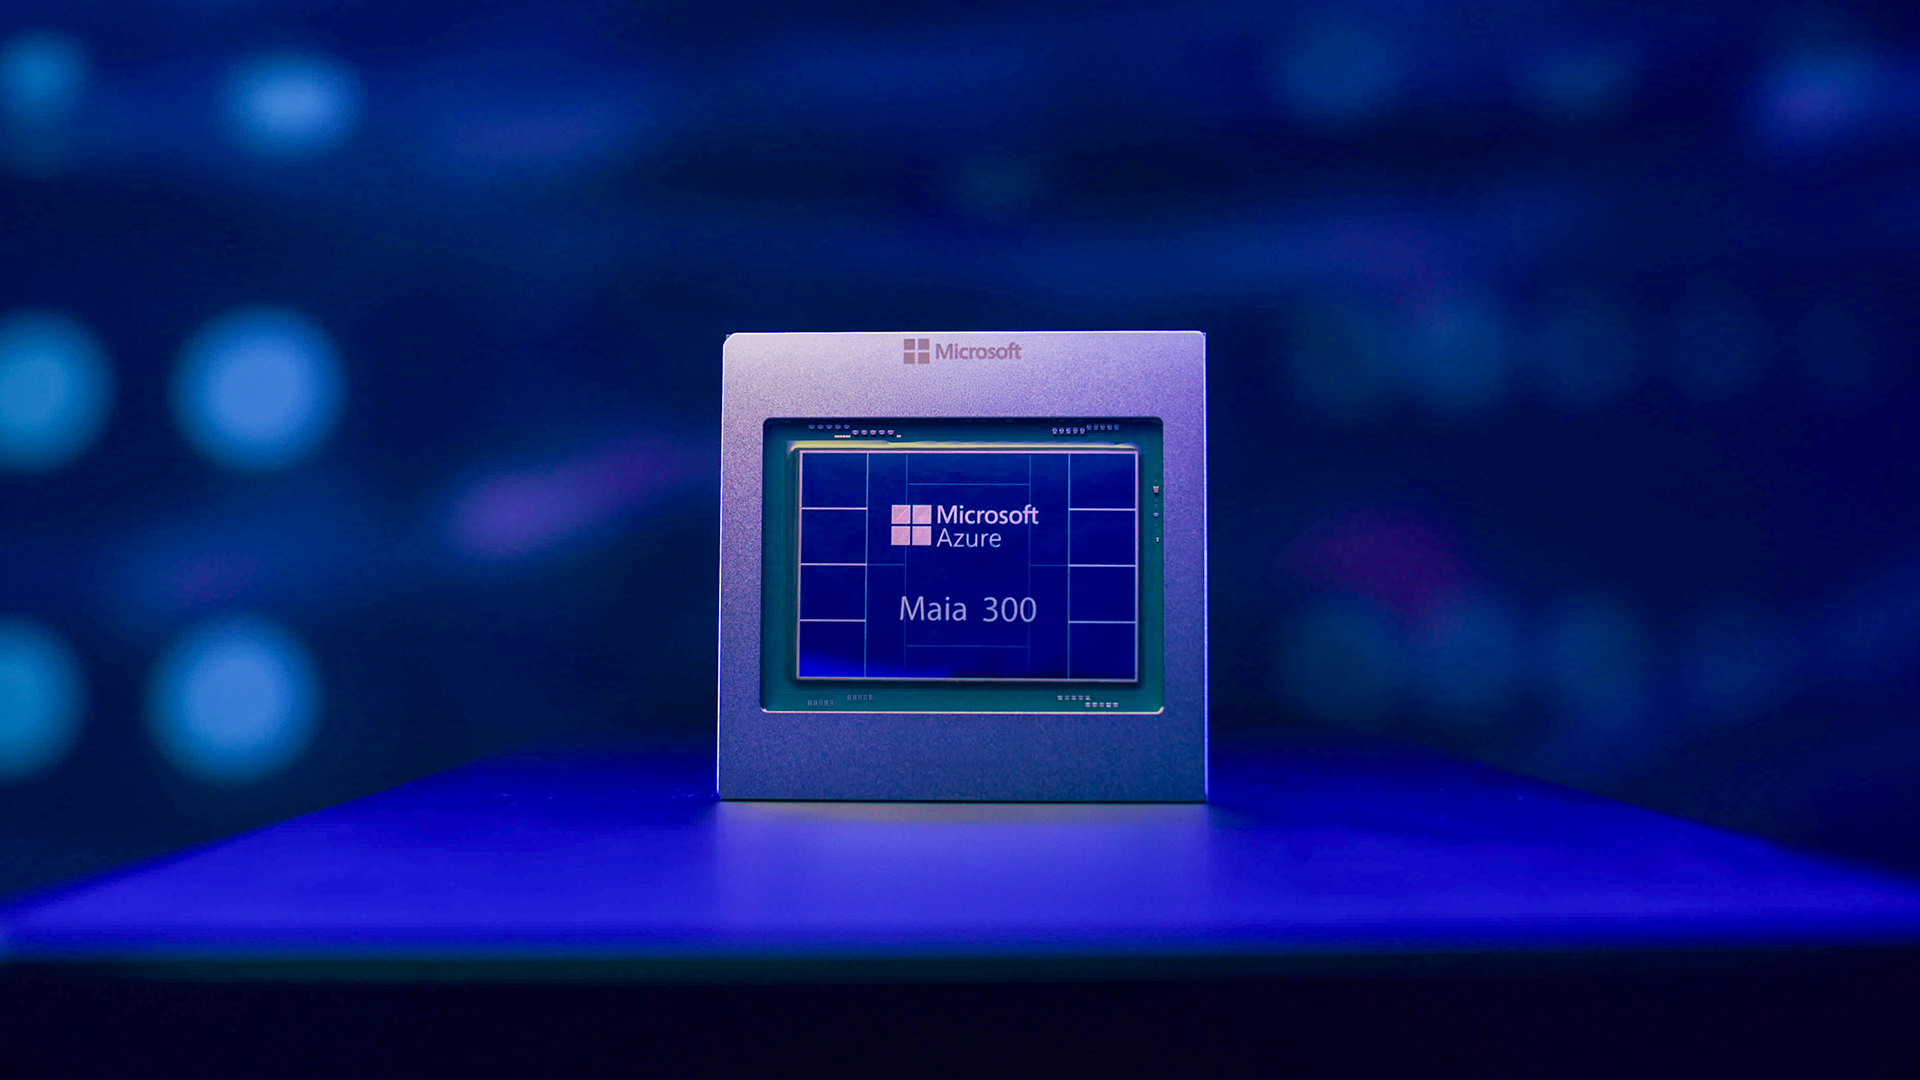
사진: Microsoft, Azure Maia 300 프로토타입 칩(OCP Global Summit 2026 공개 자료). 패키지 중앙 Die 표면에 4개 Cluster 격자가 식별됨
Rebellions Rebel100(개발명 REBEL-Quad)은 Samsung SF4X 공정의 320mm² Compute Chiplet 4개를 UCIe-Advanced로 연결한 System-in-Package이다. Chiplet마다 HBM3E 36GB 1 Stack이 귀속되어 패키지 전체로 144GB를 구성하며, 패키징은 TSMC CoWoS-S이고 전력 과도 응답 억제를 위한 Integrated Silicon Capacitor(ISC) Die 4개가 함께 탑재된다. UCIe 링크는 Lane당 16Gbps, 집계 약 4TB/s, Chiplet 간 지연 약 11ns로 발표되었으며, 2D Mesh Network-on-Chip이 UCIe를 경유하여 4개 Chiplet에 걸쳐 확장되므로 소프트웨어 관점에서는 단일 프로세서로 인식된다는 것이 Rebellions의 설명이다. FP8 2 PFLOPS, TDP 600W이다.
세 구조를 병치하면 분할 방식은 세 갈래로 구분된다. AMD는 Compute(XCD), Cache·Fabric(FCD), I/O(I/O Die)를 상이한 공정의 Die로 분리한 이종 분할, Microsoft는 Compute를 단일로 유지하고 I/O와 Memory Controller만 분리한 분할, Rebellions는 IOD 없이 동일 Compute Chiplet을 복제하여 직접 연결한 동종 분할에 해당한다.
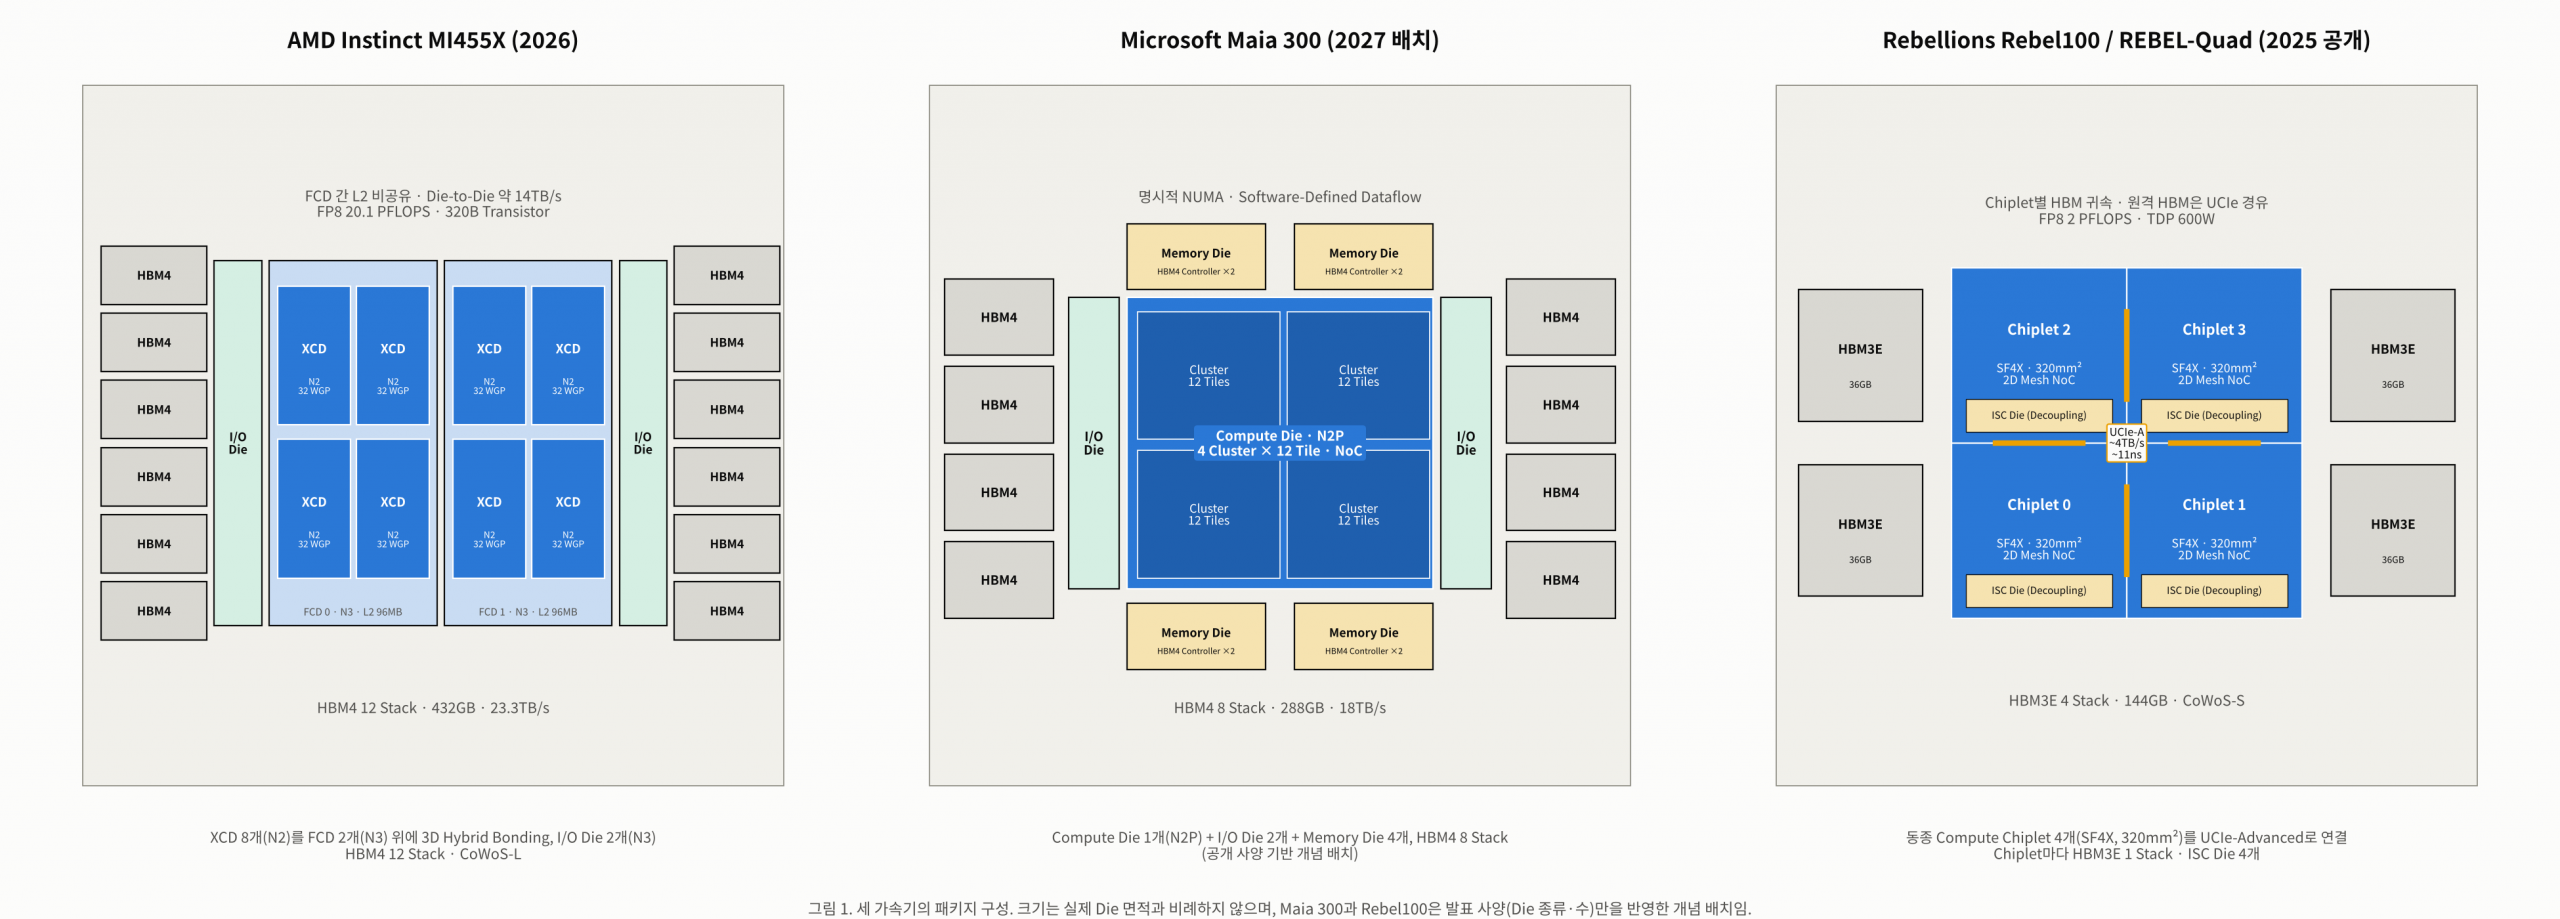
그림 1. AMD MI455X(XCD 8개, FCD 2개, IOD 2개)와 Microsoft Maia 300(Compute Die 1개, Memory Die 4개, I/O Die 2개)의 Chiplet 구조 비교. Rebellions Rebel100(동종 Compute Chiplet 4개, UCIe 연결)의 구조는 1절 서술 참조. 화살표는 LLM Inference 시 데이터 이동을 나타내는 개념도임
2. 적층 방식의 비교
AMD는 XCD를 FCD 위에 적층하는 3D 구조와 HBM을 측면에 배치하는 2.5D CoWoS-L을 병용한다. XCD가 FCD 위에 적층되는 이 구조에서는 XCD와 L2 사이의 수직 연결이 짧은 대신 열 밀도가 상승하고, 두 FCD 사이의 통신은 Interposer를 경유하는 약 14TB/s의 Die-to-Die 링크에 의존한다. CoWoS-L은 Interposer를 작은 Local Silicon Interconnect 조각과 유기 재배선층으로 구성하여 단일 Silicon Interposer의 Reticle 한계를 넘는 패키지 면적을 확보하는 방식이며, HBM4 12 Stack을 수용하기 위한 선택으로 해석된다. Rebellions는 Compute Chiplet 4개와 HBM을 모두 CoWoS-S Interposer 위 단일 층에 배치하고 Chiplet 간 연결을 Interposer 배선의 UCIe-Advanced로 처리하므로, 3D 적층 없이 2.5D만으로 Compute를 분할한 사례이다. Maia 300은 공개 자료 기준으로 3D 적층 언급이 없으며, Compute·I/O·Memory Die가 Interposer 위 단일 층에 놓이는 2.5D 구조로 파악된다. Microsoft는 “HBM Stack을 Compute에 근접 배치하기 위한 Advanced Packaging”으로만 설명하므로 세부 공정은 추가 공개를 요한다.
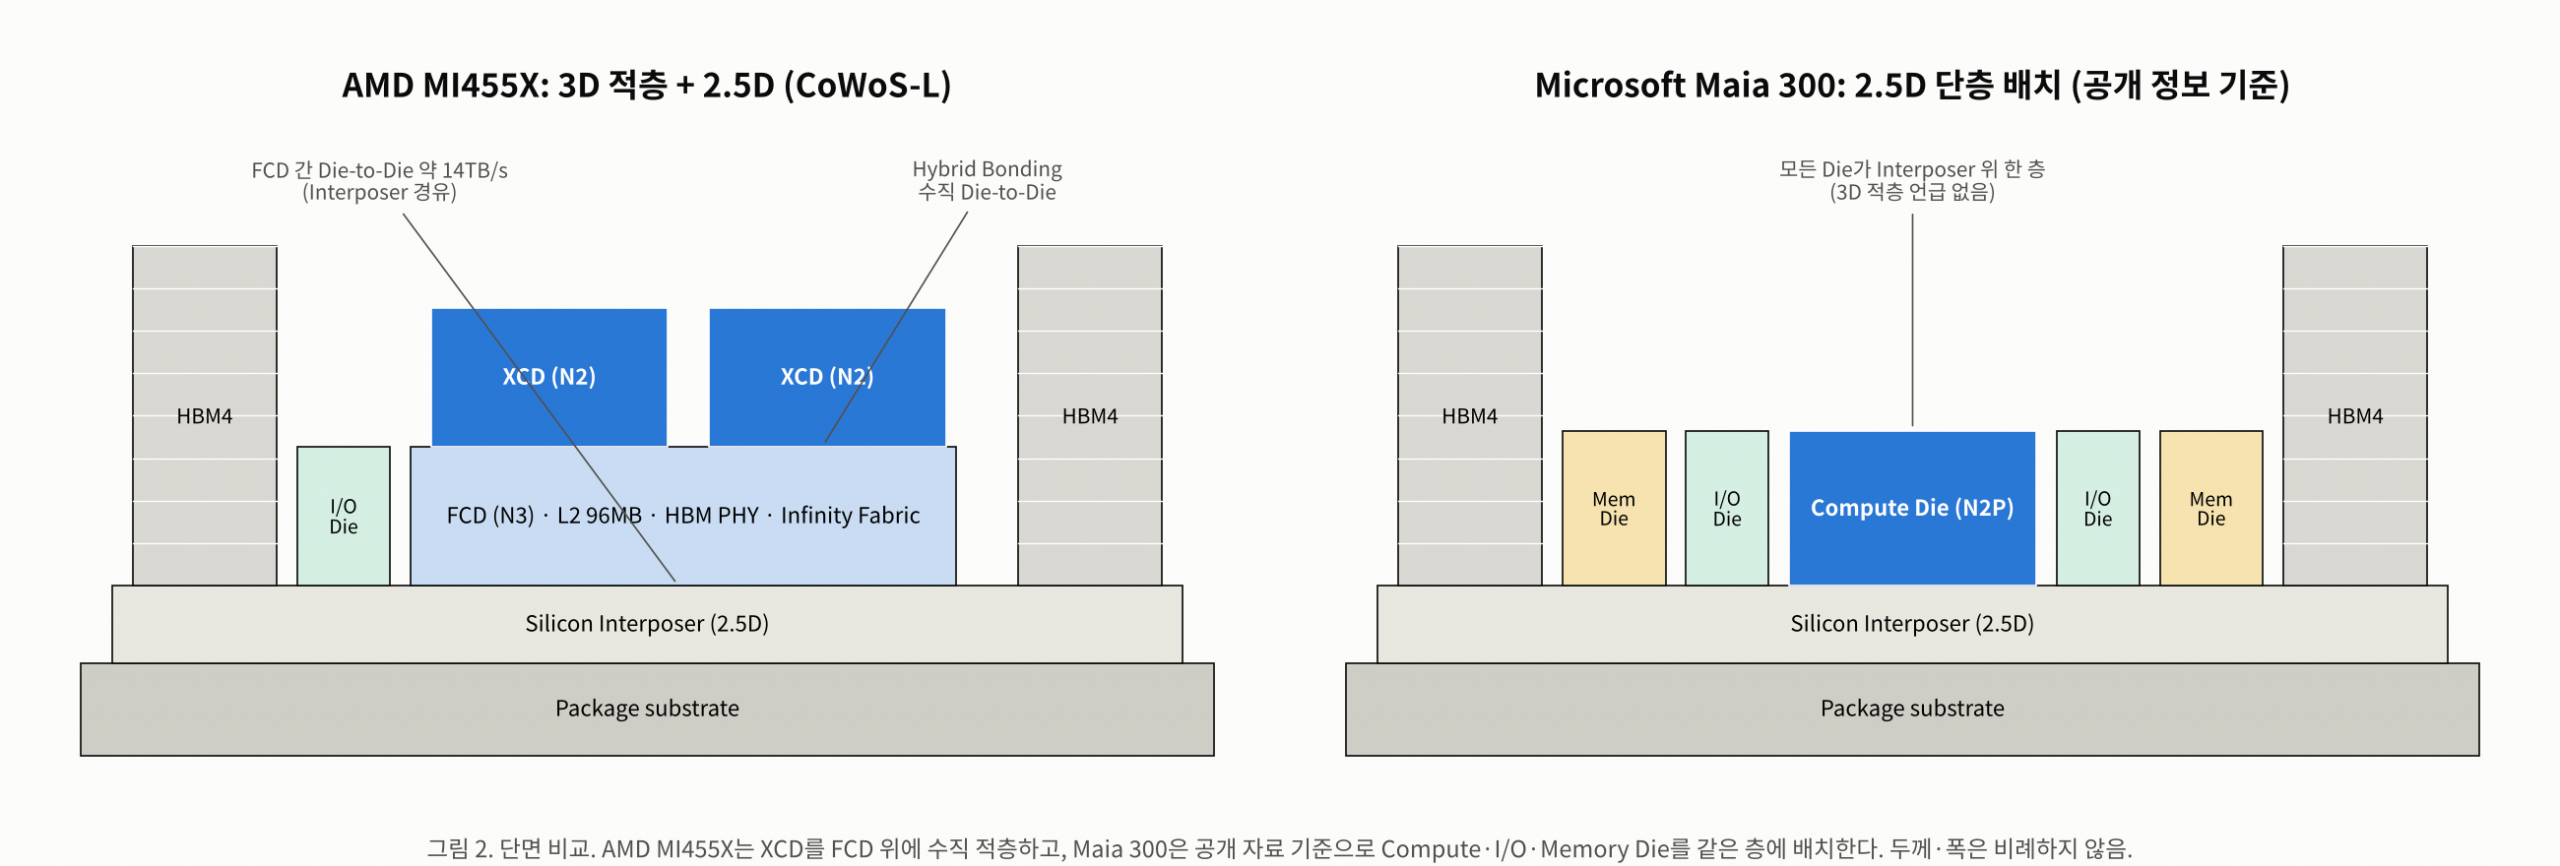
그림 2. 단면 비교. AMD MI455X는 XCD를 FCD 위에 수직 적층하고, Maia 300은 공개 정보 기준으로 모든 Die를 동일 층에 배치함
3. 수치로 본 설계 방향
세대별 사양을 동일 축에 배치하면 두 회사의 방향이 구분된다. Microsoft는 Maia 200에서 300으로 이행하며 FP8 연산을 5.1에서 6.9 PFLOPS로 1.35배 증가시킨 반면 HBM 대역폭은 7.1에서 18TB/s로 2.5배 증가시켰다. AMD는 MI355X에서 MI455X로 이행하며 FP8 연산을 5.0에서 약 20 PFLOPS로 4배, 대역폭을 8.0에서 23.3TB/s로 2.9배 증가시켰다. 연산 1 PFLOPS당 대역폭으로 환산하면 Maia 300은 2.61TB/s, MI455X는 1.17TB/s로 산정된다. Maia 300은 대역폭 측으로, MI455X는 연산 측으로 균형을 이동시킨 것이다.
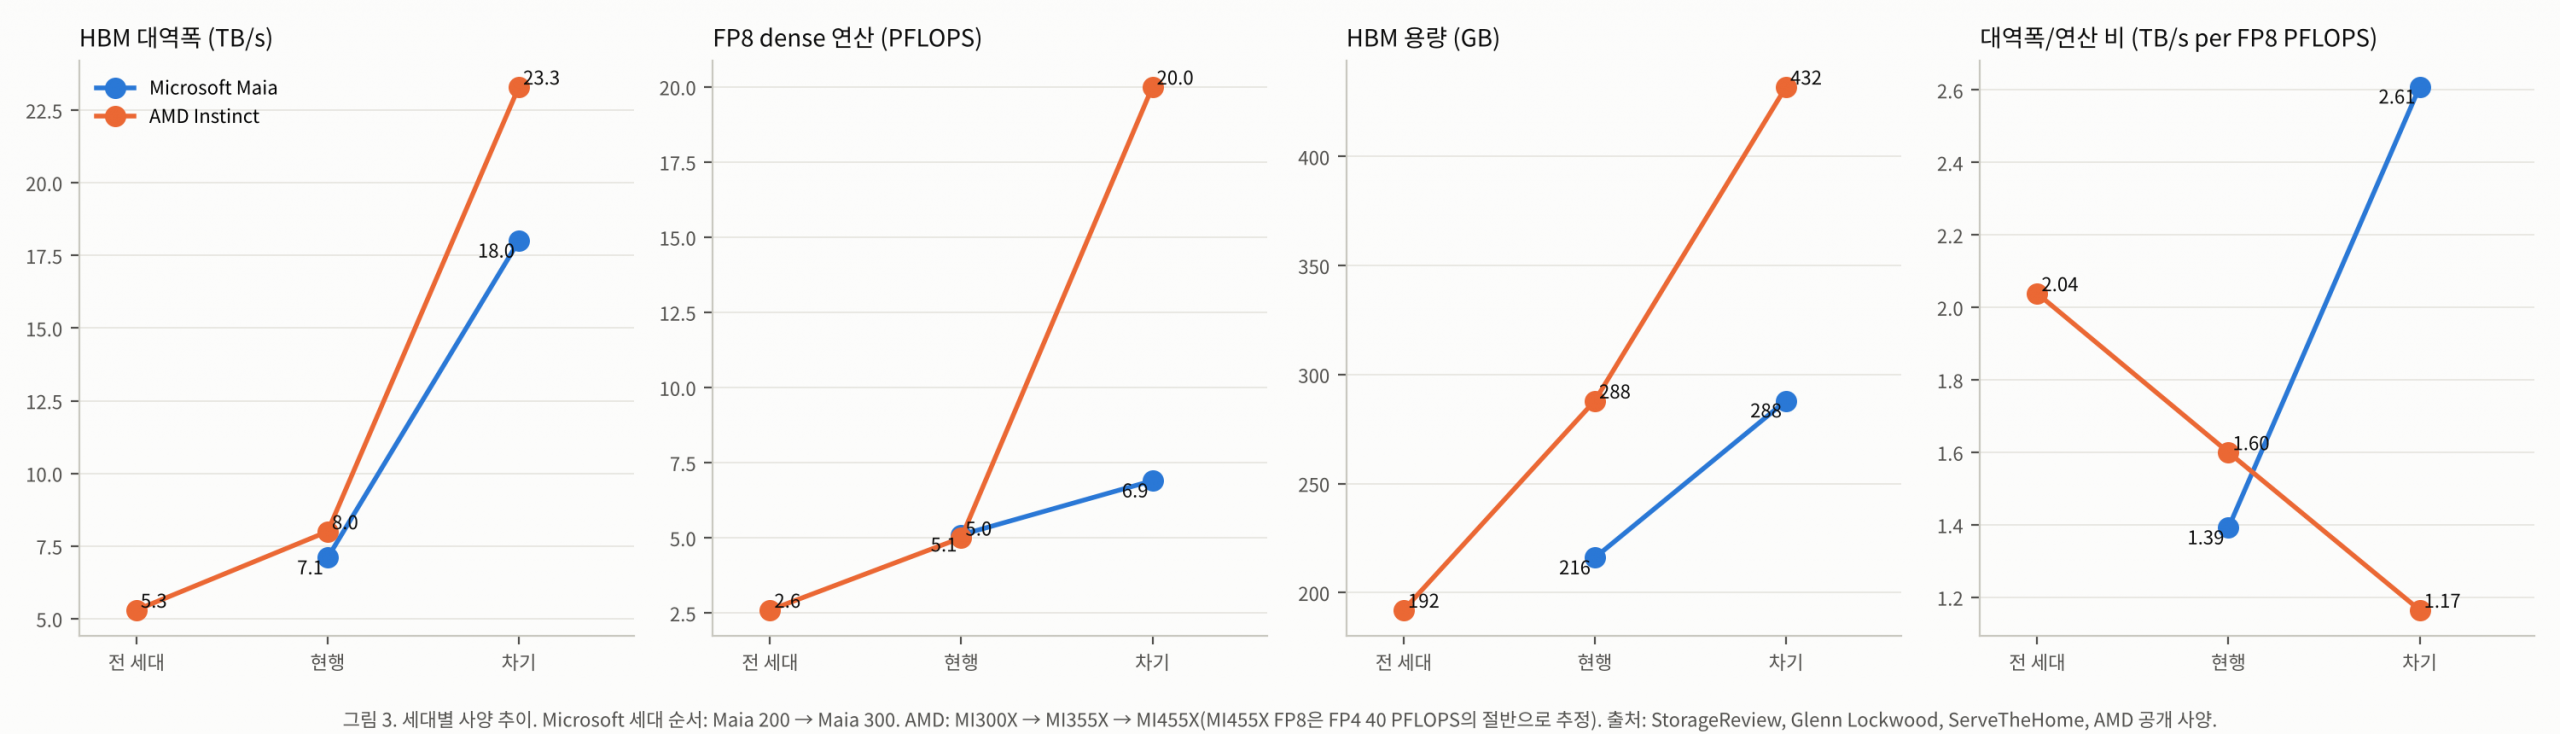
그림 3. 세대별 사양 추이. MI455X의 FP8 수치는 발표된 FP4 40 PFLOPS의 절반으로 산정함
이 차이는 두 제품의 역할과 일치한다. Maia 300은 Microsoft 자사 서비스의 Inference 전용 가속기이며, Decode 단계의 병목은 연산보다 KV cache와 Weight 적재 대역폭에 있다. MI455X는 학습과 Inference를 모두 대상으로 하는 범용 GPU이므로 연산 밀도의 유지가 요구된다. 따라서 Maia 300의 Chiplet 분할은 HBM4 8 Stack을 수용할 Beachfront(Die 가장자리 길이)의 확보가 목적이고, AMD의 XCD 분할은 Reticle 한계와 수율 문제의 해소가 목적이다. 분할의 동기가 상이하므로 분할의 축 또한 상이하다.
4. 구조와 무관하게 잔존하는 NUMA
Compute를 단일 Die로 유지하더라도 메모리 접근이 균일해지는 것은 아니다. Microsoft는 Maia 300의 메모리 모델을 명시적 NUMA로 규정하고, 빈번히 접근하는 데이터를 해당 Compute 근처에 배치하는 책임을 Software-Defined Dataflow에 부여한다. Memory Die 4개가 각각 HBM4 2 Stack을 담당하는 구조라면 Compute Die의 Cluster와 Memory Die 사이의 거리에 따라 지연이 상이해지는 것은 구조상 필연이다.
Rebel100에서는 NUMA가 구조적으로 더욱 뚜렷하다. HBM이 Chiplet별로 1 Stack씩 귀속되므로 타 Chiplet에 결합된 HBM 접근은 반드시 UCIe 링크를 경유하며, 집계 4TB/s의 UCIe 대역폭을 4개 Chiplet이 분할하여 사용한다. “단일 프로세서로 인식된다”는 설명은 주소 공간과 NoC 토폴로지 관점의 서술이고, 지연과 대역폭의 비균일성은 잔존한다. 따라서 KV cache와 Weight를 각 Chiplet의 Local HBM에 분할 배치하고 Chiplet 경계를 넘는 접근을 최소화하는 것이 성능의 전제가 된다.
AMD에서는 이 문제가 하드웨어 일관성 수준에서 드러나며, 세대에 따라 그 단위가 변경되었다. MI300X와 MI355X에서는 XCD마다 L2가 독립적으로 존재하고 XCD 간 L2가 비일관성(Non-Coherent)이었으므로, 하나의 작업을 하나의 XCD 내부에 한정하면(XCD Confinement) Cache Maintenance 없이 L2를 재사용할 수 있었으나 XCD 경계를 넘는 순간 IOD 경유 비용과 일관성 비용이 동시에 발생하였다. MI455X는 L2를 XCD에서 FCD로 이전하여 XCD 4개가 96MB L2 하나를 공유하도록 하였고, 이로써 XCD 간 Atomic 연산이 개선되고 MI300 계열에서 전역 가시성 확보에 필요하였던 Kernel 경계의 Cache Flush가 제거되었다. 다만 한 FCD의 WGP는 다른 FCD의 L2에 접근할 수 없으므로, 일관성 단위가 XCD 8개에서 FCD 2개로 확대되었을 뿐 FCD 경계의 NUMA는 잔존한다. 각 L2가 전역 주소 전체를 Cache할 수 있어 Die-to-Die 트래픽이 완화되지만, 작업을 FCD 단위로 배치하는 것이 여전히 유리하다. Maia 300이 NUMA를 소프트웨어에 노출시킨 결정은, 하드웨어가 Locality 단위를 은폐하지 않고 드러내는 편이 Inference 가속기에서도 유리하다는 판단으로 해석된다. “작업을 하드웨어 Locality 단위에 한정하고 단위 간 통신을 명시적으로 관리한다”는 원칙이 이종 Compute 분할형(AMD), Memory·I/O 분할형(Microsoft), 동종 Compute 분할형(Rebellions) 세 구조 모두에 적용되는 것이다.
5. 전력과 Rack 수준의 함의
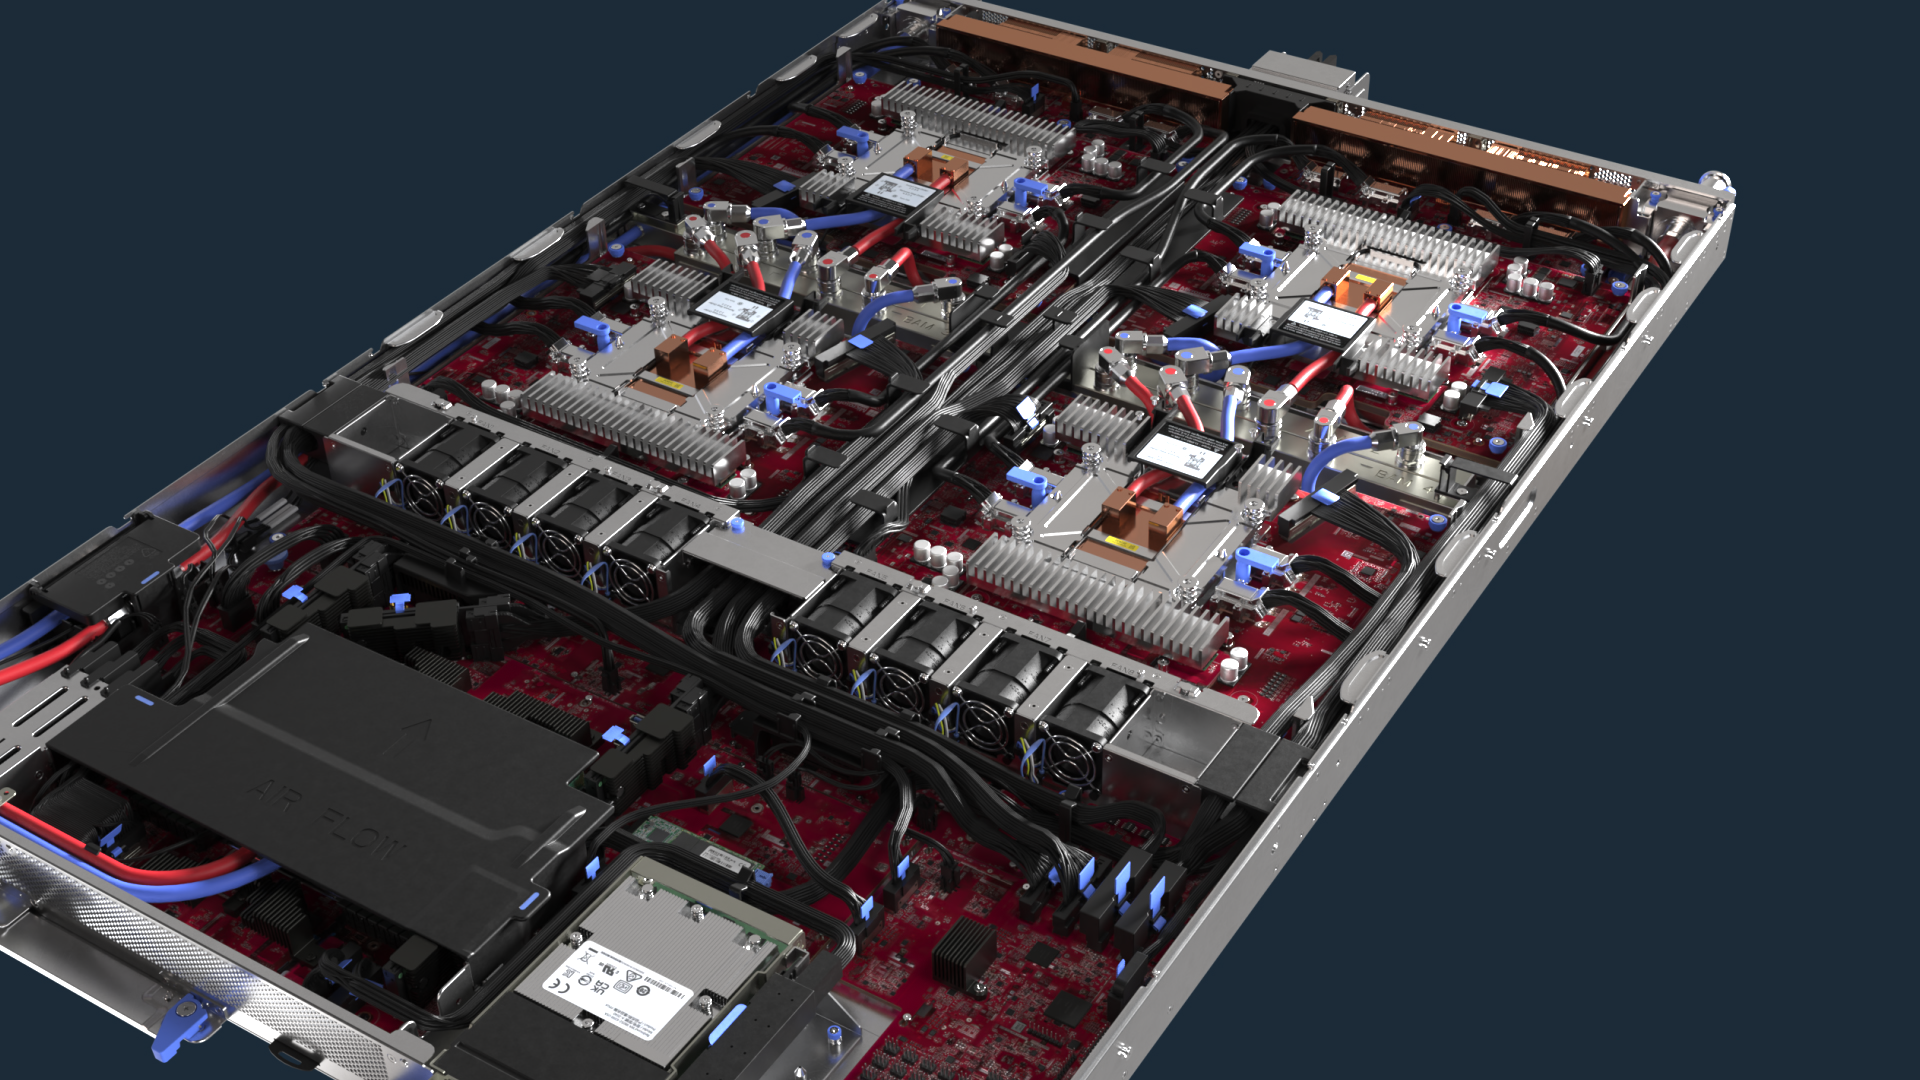
Maia 300의 TDP는 950W로 Maia 200(750W) 대비 27% 상승하였으며, Rack당 96개를 167kW에 수용한다. MI355X는 1,400W이고 MI455X는 공식 TDP가 미공개이나 Helios Rack 전력으로부터 2kW 이상으로 추정된다. 대역폭 중심 설계가 연산 중심 설계보다 전력 증가 폭이 작다는 점이 수치로 확인된다. GPU Cluster 운영 관점에서 두 가지 함의가 도출된다. 첫째, 자원 관리 단위가 “GPU 한 장”에서 Die 또는 NUMA domain으로 세분화될 가능성의 증대이다. MI300 계열의 DPX·QPX Partition 모드는 그 초기 형태이며, MI455X의 FCD 2개 구조, Maia 300의 Cluster·Memory Die 구조, Rebel100의 Chiplet 단위 구조 또한 동일 방향의 분할을 허용할 여지가 있다. 둘째, Inference 전용 가속기와 범용 GPU의 사양 격차가 대역폭/연산 비로 정량화되므로, 워크로드별 배치 기준을 이 비율로 수립하는 것이 가능해진다.
6. 국내 사례: 두 갈래 분할 방식의 국내 재현
국내 두 회사는 Chiplet 분할의 상이한 갈래를 각각 채택하였다. Rebellions는 전술한 바와 같이 Compute를 동종 Chiplet 4개로 분할하는 방식이다. FuriosaAI의 현행 제품 RNGD는 TSMC 5nm 단일 Die에 HBM3 48GB(1.5TB/s), SRAM 256MB, FP8 512 TFLOPS, TDP 180W의 Monolithic 설계이며, 2026년 5월 Broadcom과 발표한 3세대 가속기에서 2nm Compute Die와 Scale-up Networking용 별도 I/O Die를 Broadcom의 Advanced Packaging으로 통합하고 HBM4/4E를 채택할 예정이다(2028년 상반기 샘플링). 즉 FuriosaAI의 차세대는 Maia 300과 동일한 Compute 통합·I/O 분리형에 해당한다. 국내에서도 Compute 분할형과 I/O 분리형이 병존하게 되며, 어느 방식이든 Locality 관리 책임이 소프트웨어 스택으로 이전된다는 점은 동일하다.
7. 결론
Maia 300, AMD Instinct, Rebellions Rebel100은 모두 Chiplet이나 분할의 축이 상이하다. AMD는 Compute를 8개 XCD로 분할하여 수율과 면적 문제를 해소하였고, MI455X에서 L2를 FCD로 이전하여 일관성 단위를 XCD 8개에서 FCD 2개로 확대하였으나 FCD 경계의 NUMA는 소프트웨어가 관리하여야 한다. Microsoft는 Compute Die를 단일로 유지하고 Memory·I/O를 분리하여 HBM4 대역폭을 2.5배 확대하였으며, NUMA를 설계 초기부터 명시적으로 노출하였다. Rebellions는 IOD 없이 동종 Compute Chiplet을 UCIe로 직접 연결하여 패키지 전체를 단일 Mesh로 결합하였고, 그 대신 Chiplet별로 귀속된 HBM 간의 비균일 접근을 소프트웨어가 관리하여야 한다. 향후 어느 방식이 주류가 될지는 Inference 비중이 결정할 것이나, 세 구조 모두에서 Locality를 소프트웨어가 관리하여야 한다는 점은 이미 확정된 사실이다.
실물 사진 출처
본문 도해는 모두 공개 사양을 바탕으로 직접 작성한 것이며, 실물 사진은 아래 출처를 참조함.
Microsoft Maia 300 공식 이미지(Microsoft 제공, news.microsoft.com/maia-2026):
- 프로토타입 칩 hero 이미지: https://msftstories.thesourcemediaassets.com/sites/760/2026/10/Maia-300-prototype-chip-00_hero.png
- 칩 render: https://msftstories.thesourcemediaassets.com/sites/760/2026/10/Azure-Maia-300-chip-render.png
- 칩·서버·rack render: https://msftstories.thesourcemediaassets.com/sites/760/2026/10/Azure-Maia-300-Chip-to-Server-to-Rack-Render.png
- 보드 사진: https://msftstories.thesourcemediaassets.com/sites/760/2026/10/Maia-300-board-1.jpg
- 서버 사진: https://msftstories.thesourcemediaassets.com/sites/760/2026/10/Maia-300-server-1.jpg
- 공식 발표 블로그: https://blogs.microsoft.com/blog/2026/10/12/microsoft-to-expand-azure-maia-system-to-multi-gigawatt-deployments/
Rebellions Rebel100 / REBEL-Quad:
- ServeTheHome Hot Chips 2025 기사(패키지·보드 사진 수록): https://www.servethehome.com/rebellions-rebel-quad-ucie-and-144gb-hbm3e-accelerator-at-hot-chips-2025/
- Rebellions 공식 뉴스룸: https://rebellions.ai/newsroom/rebellions-debuts-rebel-quad-at-hot-chips-2025-breaking-ais-energy-tax-with-high-performance-chiplet-innovation/
- Rebellions Rebel100 제품 페이지: https://rebellions.ai/rebellions-product/rebel100/
AMD MI455X 패키지·Die 자료:
- AMD Instinct MI400 Series 제품 페이지: https://www.amd.com/en/products/accelerators/instinct/mi400.html
- AMD CDNA 5 Architecture Whitepaper: https://www.amd.com/content/dam/amd/en/documents/products/technologies/cdna/amd-cdna5-whitepaper.pdf
- ServeTheHome MI455X deep dive(패키지 사진 수록): https://www.servethehome.com/amd-instinct-mi455x-deep-dive-cdna-5-marks-the-next-era-of-instinct/
- StorageReview, MI455X and Helios: https://www.storagereview.com/news/amd-mi455x-and-helios-432gb-hbm4-72-gpu-racks-and-a-real-answer-to-vera-rubin
참고 자료
- StorageReview, “Microsoft Maia 300 Puts 288GB of HBM4 at 18TB/s on an N2P Chiplet”: https://www.storagereview.com/news/microsoft-maia-300-hbm4-n2p-chiplet-96-accelerator-rack
- IN Electronics, “Microsoft details Maia 300 chiplet accelerator architecture”: https://www.inelectronics.co.uk/microsoft-details-maia-300-chiplet-accelerator-architecture/
- Glenn Lockwood, Maia 200 정리: https://glennklockwood.com/garden/processors/Maia-200
- HPCwire, Maia 300 발표 보도자료: https://hpcwire.com/off-the-wire/microsoft-announces-maia-300-its-next-gen-custom-ai-chip
- ServeTheHome, AMD Instinct MI455X Deep Dive: https://www.servethehome.com/amd-instinct-mi455x-deep-dive-cdna-5-marks-the-next-era-of-instinct/
- AMD Instinct MI300X, MI355X, MI455X 공개 사양(AMD 제품 페이지)
- Chips and Cheese, “AMD’s Instinct MI455X: Aiming for the Sun”: https://chipsandcheese.com/p/amds-instinct-mi455x-aiming-for-the
- ServeTheHome, “Rebellions REBEL-Quad UCIe and 144GB HBM3E Accelerator at Hot Chips 2025”: https://www.servethehome.com/rebellions-rebel-quad-ucie-and-144gb-hbm3e-accelerator-at-hot-chips-2025/
- abit.ee, “Rebellions’ Rebel100 AI accelerator: quad-chiplet UCIe design (ISSCC 2026)”: https://abit.ee/en/artificial-intelligence/rebellions-rebel100-ucie-ai-accelerator-isscc-2026-nvidia-h200-hbm3e-multi-chiplet-en
- FuriosaAI, RNGD Specifications: https://furiosa.ai/renegade-spec
- FuriosaAI–Broadcom 3세대 가속기 발표(2026.05): https://finance.yahoo.com/news/furiosaai-partners-broadcom-build-next-232300613.html