이번 포스팅에서는 GTC 2025 키노트 발표 내용 중 Hopper의 성능 향상을 설명하는 그래프를 해석해 보자. 젠슨 황이 발표 중에 “우리는 수학적인 표현을 대중적인 스피치에서 전달하는 몇 안 되는 회사다”라고 말하기도

글쓰기, 여행, 프로그래밍, 리뷰
이번 포스팅에서는 GTC 2025 키노트 발표 내용 중 Hopper의 성능 향상을 설명하는 그래프를 해석해 보자. 젠슨 황이 발표 중에 “우리는 수학적인 표현을 대중적인 스피치에서 전달하는 몇 안 되는 회사다”라고 말하기도

2025년 기준으로 GPU의 인기가 예전만 못해진 걸까? 아니면 오히려 더 뜨거워졌을까? 미시적·거시적으로 살펴보면, 데이터 센터(DC)나 리테일(RTX) 분야에서는 여전히 높은 수요를 보이고 있는 듯하다. 다만, 이전 세대인 ‘Hopper’ 시리즈에 대한 관심은

기술서적 집필 두 번째로 집필한 ‘Do It! C++ 완전 정복’이 3년이 넘는 집필 기간을 거처 드디어 ’24년 3월 25일부터 판매가 되었다. 25살(고전 한국 나이) 직장 생활을 한 후 총 3개의

들어 가며.. 인공지능에 대한 개발 관심도와 기술이 나날이 발전하고 있습니다. 조금 더 빠른 속도와 높은 정확도를 얻기 위한 무한 경쟁이 쉬지 않고 이루어 지고 있죠. GPGPU사용이 당연시 되는 Deep Learning
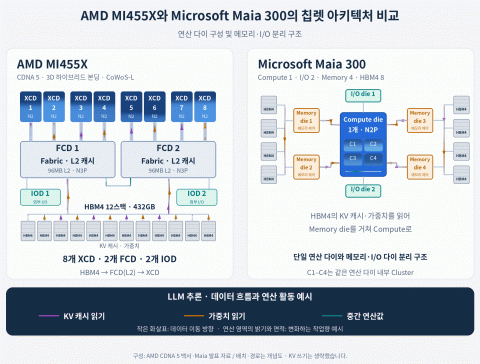
칩렛(Chiplet) 구조란 무엇인가? AMD, Azure, 리벨리온으로 살펴보는 칩렛의 의미 칩렛(Chiplet) 구조란 무엇인가? AMD, Azure, 리벨리온으로 살펴보는 칩렛의 의미 대표 이미지: Chiplet 패키지의 Exploded View 일러스트(Higgsfield gpt_image_2_5 생성). 아래부터 Package Substrate,
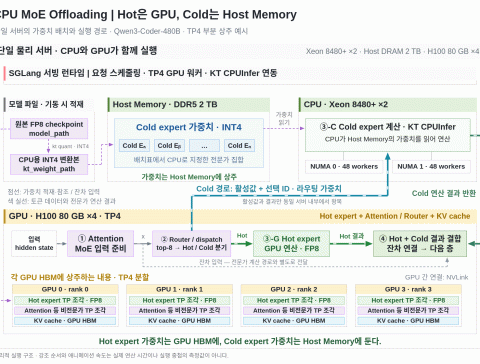
LLM INFERENCE · CPU–GPU HYBRID CPU MoE Offloading:GPU 메모리의 한계를 넘으면 무엇이 달라질까 Hot expert는 GPU에, Cold expert는 Host Memory에: 실행 구조와 기본 성능, 최적화의 출발점 그림 움직임 멈춤 큰

vLLM Performance · Engineering Notes —종합편 K-Exaone 4.7배 빠르게 하기 이번 편은 앞선 1~4편에서 검증한 방법을 종합한다. 기본 vLLM 대비 누적 처리량, 내 모델에 적용하는 절차, 그리고 시리즈 전체의 결론을

vLLM Performance · Engineering Notes — 4편 bestKpad 위의 두 방법 — W4A4와 동적-K 3편에서 확립한 bestKpad를 기준선으로 두고, 양자화(W4A4)와 런타임 동적-K가 그 처리량을 넘어서는지 측정했다. W4A4는 11개 모델 중

CUDA를 위한 Draft를 더미로 채우니, 70개 케이스 중 68개 케이스가 뒤집혔다 — vLLM Engineering Notes 3편 vLLM Performance · Engineering Notes — 3편 CUDA를 위한 Draft를 더미로 채우니, 70개 케이스
칩이 아니라 ‘공장’을 판다 — NVIDIA가 AI 팩토리 전체를 하나의 청사진으로 묶었다. · NVIDIA DSX 종합 분석 전력이 병목인 시대, 경쟁의 단위는 FLOPS가 아니라 ‘메가와트당 토큰’이다. NVIDIA DSX는 단일 칩·서버

그 설정, 다른 모델에서도 통한다. 거의. — vLLM Performance · Engineering Notes vLLM Performance · Engineering Notes — 2편 그 설정, 다른 모델에서도 통한다. 거의. 전편에서 정리한 suffix 구성을 10개